À propos de ce cours
Objectifs de la leçon
- Comparer bases relationnelles et bases orientées documents sur des critères précis.
- Dépasser les idées reçues sur SQL et NoSQL.
- Choisir une base de données pour un projet, et justifier ce choix.
- Connaître la persistance polyglotte.
Pas de meilleure base, mais une base adaptée
Vous savez maintenant utiliser MySQL avec TypeORM ou Prisma, et MongoDB avec Mongoose. Le choix ne se fait pas sur la popularité, mais sur la forme des données et la façon dont l'application les utilise.

La forme des données et leur usage guident le choix.
Comparaison détaillée
| Critère | Relationnel (MySQL, PostgreSQL) | Documents (MongoDB) |
|---|---|---|
| Modèle | tables, lignes, clés étrangères | collections de documents JSON imbriqués |
| Schéma | imposé par la base, évolue par migrations | libre côté base ; imposé par l'application (Mongoose) |
| Intégrité | contraintes en base : clés étrangères, unicité, CHECK | unicité par index ; pas de clé étrangère : la cohérence des références est à la charge de l'application |
| Relations | jointures performantes et souples | imbrication ; $lookup / populate moins naturels |
| Transactions | natives, multi-tables, depuis toujours | atomiques sur un document ; multi-documents possibles (sur un ensemble de réplicas) mais plus coûteuses |
| Requêtes | SQL standard, très expressif pour les statistiques | API JSON et pipeline d'agrégation |
| Montée en charge | surtout verticale (serveur plus puissant) ; réplication en lecture | conçue pour la répartition horizontale (sharding) |
| Hébergement courant | présent chez presque tous les hébergeurs | Atlas, VPS, conteneurs |
Quelques idées reçues
- « NoSQL est plus rapide. » Pour lire un document complet par son identifiant, MongoDB est très efficace ; pour une statistique qui croise plusieurs ensembles de données, une base relationnelle bien indexée l'est souvent davantage. La vitesse dépend surtout des index et de la modélisation.
- « NoSQL n'a pas de schéma. » Les données ont toujours une structure : soit la base la garantit, soit l'application. Sans Mongoose et sans DTO, les documents incohérents s'accumulent.
- « MongoDB n'a pas de transactions. » Elles existent depuis la version 4.0, mais nécessitent un ensemble de réplicas et sont moins naturelles qu'en SQL.
- « SQL ne passe pas à l'échelle. » Des sites parmi les plus visités utilisent MySQL ou PostgreSQL. La plupart des projets n'atteindront jamais les volumes où cette question se pose.
- « On peut changer facilement plus tard. » Migrer de base de données est coûteux : le modèle, les requêtes et une partie de la logique changent. Le choix initial compte.
Une grille de décision
| Question | Si oui… |
|---|---|
| Les données sont-elles fortement liées (inscriptions, notes, paiements) et faut-il garantir leur cohérence ? | relationnel |
| Faut-il des transactions sur plusieurs entités (emprunt = livre + adhérent + historique) ? | relationnel |
| Les rapports et statistiques croisés sont-ils importants ? | relationnel |
| Chaque objet est-il lu et écrit en entier, avec une structure qui varie (fiches produits de catégories différentes) ? | documents |
| S'agit-il de grands volumes de données ajoutées en continu (journaux, capteurs) ? | documents (ou base spécialisée) |
| L'équipe et l'hébergement maîtrisent-ils déjà l'une des deux ? | un argument réel, à ne pas négliger |
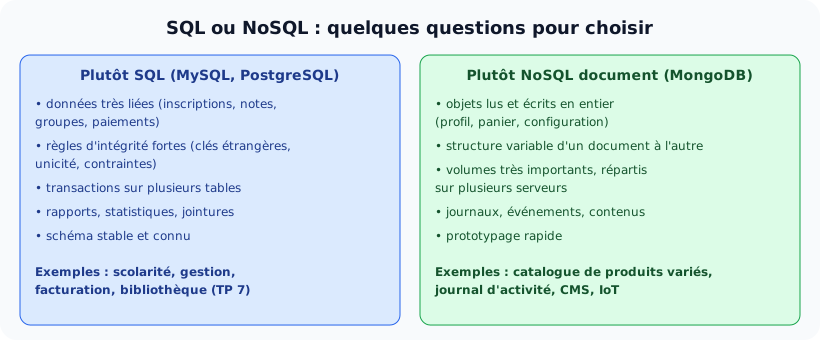
Par défaut, pour une application de gestion (scolarité, stocks, réservations, facturation), une base relationnelle est le choix le plus sûr. On choisit MongoDB quand la forme des données ou leur volume le justifie, pas par mode.
La persistance polyglotte
Un même système peut utiliser plusieurs bases, chacune pour ce qu'elle fait le mieux. Exemple pour la plateforme du centre de formation :
| Besoin | Stockage | Dans NestJS |
|---|---|---|
| Stagiaires, groupes, notes, inscriptions | MySQL | TypeORM (chapitre 11) |
| Journal d'activité (qui a fait quoi, quand), volumineux | MongoDB | Mongoose (leçon 12.3) |
| Cache des statistiques, sessions, limitation de débit | Redis | @nestjs/cache-manager, @nestjs/throttler |
| Fichiers (devoirs, photos) | disque ou stockage objet (S3) | chapitre 15 |
NestJS facilite cette organisation : chaque module importe le module de persistance dont il a besoin. Mais chaque base supplémentaire ajoute de la complexité (installation, sauvegardes, supervision) : ne l'ajoutez que pour un vrai besoin.
Activités
Activité 1 Choisir pour chaque projet
Choisissez et justifiez en deux phrases : (a) la gestion des inscriptions et des paiements du centre ; (b) un catalogue de matériel informatique dont chaque type a ses propres caractéristiques (ordinateurs : processeur, mémoire ; imprimantes : vitesse, couleur…) ; (c) l'historique de navigation des stagiaires sur la plateforme ; (d) le TP 7 (bibliothèque).
Voir le corrigé
(a) Relationnel : données liées, transactions et cohérence financière indispensables. (b) Documents : chaque fiche a une structure différente ; en relationnel, il faudrait une colonne JSON ou un modèle « attribut-valeur » complexe. (c) Documents (ou base de séries temporelles) : gros volume, ajouts continus, peu de relations. (d) Relationnel : emprunts, exemplaires et adhérents sont liés, et les emprunts exigent des transactions.
Activité 2 Les colonnes JSON
MySQL (depuis la version 5.7) et PostgreSQL proposent des colonnes de type JSON. En quoi cela nuance-t-il le choix pour le cas (b) de l'activité 1 ? Quelles limites gardent-elles ?
Voir le corrigé
Une table materiels avec les colonnes communes (référence, prix, stock) et une colonne caracteristiques JSON combine les deux mondes : intégrité et transactions pour l'essentiel, souplesse pour le reste (TypeORM : @Column({ type: 'json' }), leçon 11.3). Limites : contraintes et index sur le contenu JSON plus difficiles, requêtes moins lisibles. C'est souvent un excellent compromis qui évite une seconde base.
Activité 3 Repérer les risques
Une équipe a choisi MongoDB pour la scolarité : chaque stagiaire contient son groupe (code et intitulé recopiés) et ses notes. Citez trois problèmes qu'elle risque de rencontrer.
Voir le corrigé
(1) Renommer l'intitulé d'un groupe impose de modifier tous les stagiaires concernés (données dupliquées), avec un risque d'incohérence. (2) Les statistiques par groupe ou par matière demandent des pipelines d'agrégation complexes sur tous les documents. (3) Rien n'empêche une note de référencer un module supprimé ou un groupe inexistant : l'intégrité référentielle repose entièrement sur le code. On peut aussi citer la difficulté des opérations qui touchent plusieurs stagiaires à la fois (transferts).
Activité 4 Étude de cas argumentée
Rédigez, dans le README d'un dépôt GitHub etude-persistance, une note d'une page qui propose l'architecture de données d'une plateforme de formation en ligne : comptes et inscriptions, catalogue de cours avec des contenus de formes variées (vidéo, quiz, texte), progression de chaque apprenant, forum, journal d'activité. Pour chaque partie : base choisie, outil NestJS, justification, et un schéma (Mermaid, que GitHub affiche directement).
Voir le corrigé
Une proposition possible : MySQL pour les comptes, inscriptions, paiements et la progression (liens forts, statistiques, transactions) ; MongoDB pour les contenus de cours (structures variables) et le journal d'activité (volume) ; Redis pour le cache et les sessions. La justification doit s'appuyer sur la grille de la leçon, et discuter le coût de trois bases : une version « simple » avec MySQL seul, des colonnes JSON pour les contenus et une table d'activité partitionnée, est aussi défendable pour démarrer.
À retenir
- Le choix dépend de la forme des données et de leur usage, pas de la mode.
- Relationnel : données liées, intégrité, transactions, statistiques ; choix par défaut des applications de gestion.
- Documents : objets lus en entier, structures variables, gros volumes, répartition horizontale.
- Les colonnes JSON du relationnel offrent souvent un bon compromis.
- Persistance polyglotte : plusieurs bases si chaque besoin le justifie, au prix d'une complexité accrue.
Cet article vous a-t-il aidé ?
Merci pour votre avis sur cet article 🙏
Merci, votre message nous a bien été transmis 🙏
Cette leçon vous a été utile ? Partagez-la !