À propos de ce cours
Cette leçon explique comment Node.js fonctionne de l'intérieur : le moteur V8 qui exécute le JavaScript, la bibliothèque libuv qui fournit la boucle d'événements et les entrées / sorties asynchrones, les liaisons C++ et le pool de threads. À l'aide d'une analogie et d'exemples exécutés, elle compare le code bloquant et non bloquant, montre pourquoi un seul fil d'exécution suffit à servir de nombreuses requêtes, présente l'ordre d'exécution de la boucle d'événements et démontre comment un long calcul bloque tout un serveur, avec deux activités corrigées et un quiz.
Objectifs
- Identifier les composants de Node.js : V8, libuv, liaisons C++, API JavaScript.
- Distinguer une opération bloquante d'une opération non bloquante.
- Comprendre le rôle du fil d'exécution unique et de la boucle d'événements.
- Savoir ce qui peut bloquer un serveur Node.js, et l'éviter.
Une analogie : le serveur du restaurant
- Imaginez un restaurant avec un seul serveur. Il prend la commande de la table 1, la transmet à la cuisine, puis… il ne reste pas planté devant la cuisine à attendre. Il va prendre la commande de la table 2, puis de la table 3. Quand un plat est prêt, la cuisine sonne : il l'apporte à la bonne table.
- Node.js fonctionne exactement ainsi :
- le serveur, c'est le fil d'exécution unique qui exécute votre code JavaScript ;
- la cuisine, c'est le système d'exploitation et libuv, qui lisent les fichiers et attendent les réponses du réseau ou de la base de données ;
- la sonnette, c'est un événement: « le fichier est lu », « la requête est arrivée », « la base a répondu » ;
- la façon dont le serveur choisit sa prochaine tâche, c'est la boucle d'événements.
- Un restaurant « bloquant » aurait besoin d'un serveur par table, chacun attendant devant la cuisine. Ça fonctionne, mais cela coûte beaucoup plus cher.
Les composants de Node.js
- Votre application: votre code JavaScript et les paquets npm que vous utilisez.
- L'API de Node.js: les modules fournis avec Node.js, écrits en JavaScript :
fs(fichiers),http(serveur web),path(chemins),events(événements),stream(flux),crypto(chiffrement),os(système). - Les liaisons C++ (bindings) : elles relient ces modules JavaScript au code natif, écrit en C et C++.
- V8: le moteur JavaScript de Google. Il compile votre JavaScript en code machine et gère la mémoire (allocation, ramasse-miettes). V8 ne sait rien des fichiers ni du réseau : il exécute seulement du JavaScript.
- libuv: une bibliothèque écrite en C. C'est elle qui fournit la boucle d'événements et les entrées / sorties asynchrones, de la même façon sous Windows, Linux et macOS. Pour les opérations que le système ne sait pas faire de façon asynchrone (certaines lectures de fichiers, le chiffrement, la compression), libuv utilise un petit pool de threads: 4 par défaut.
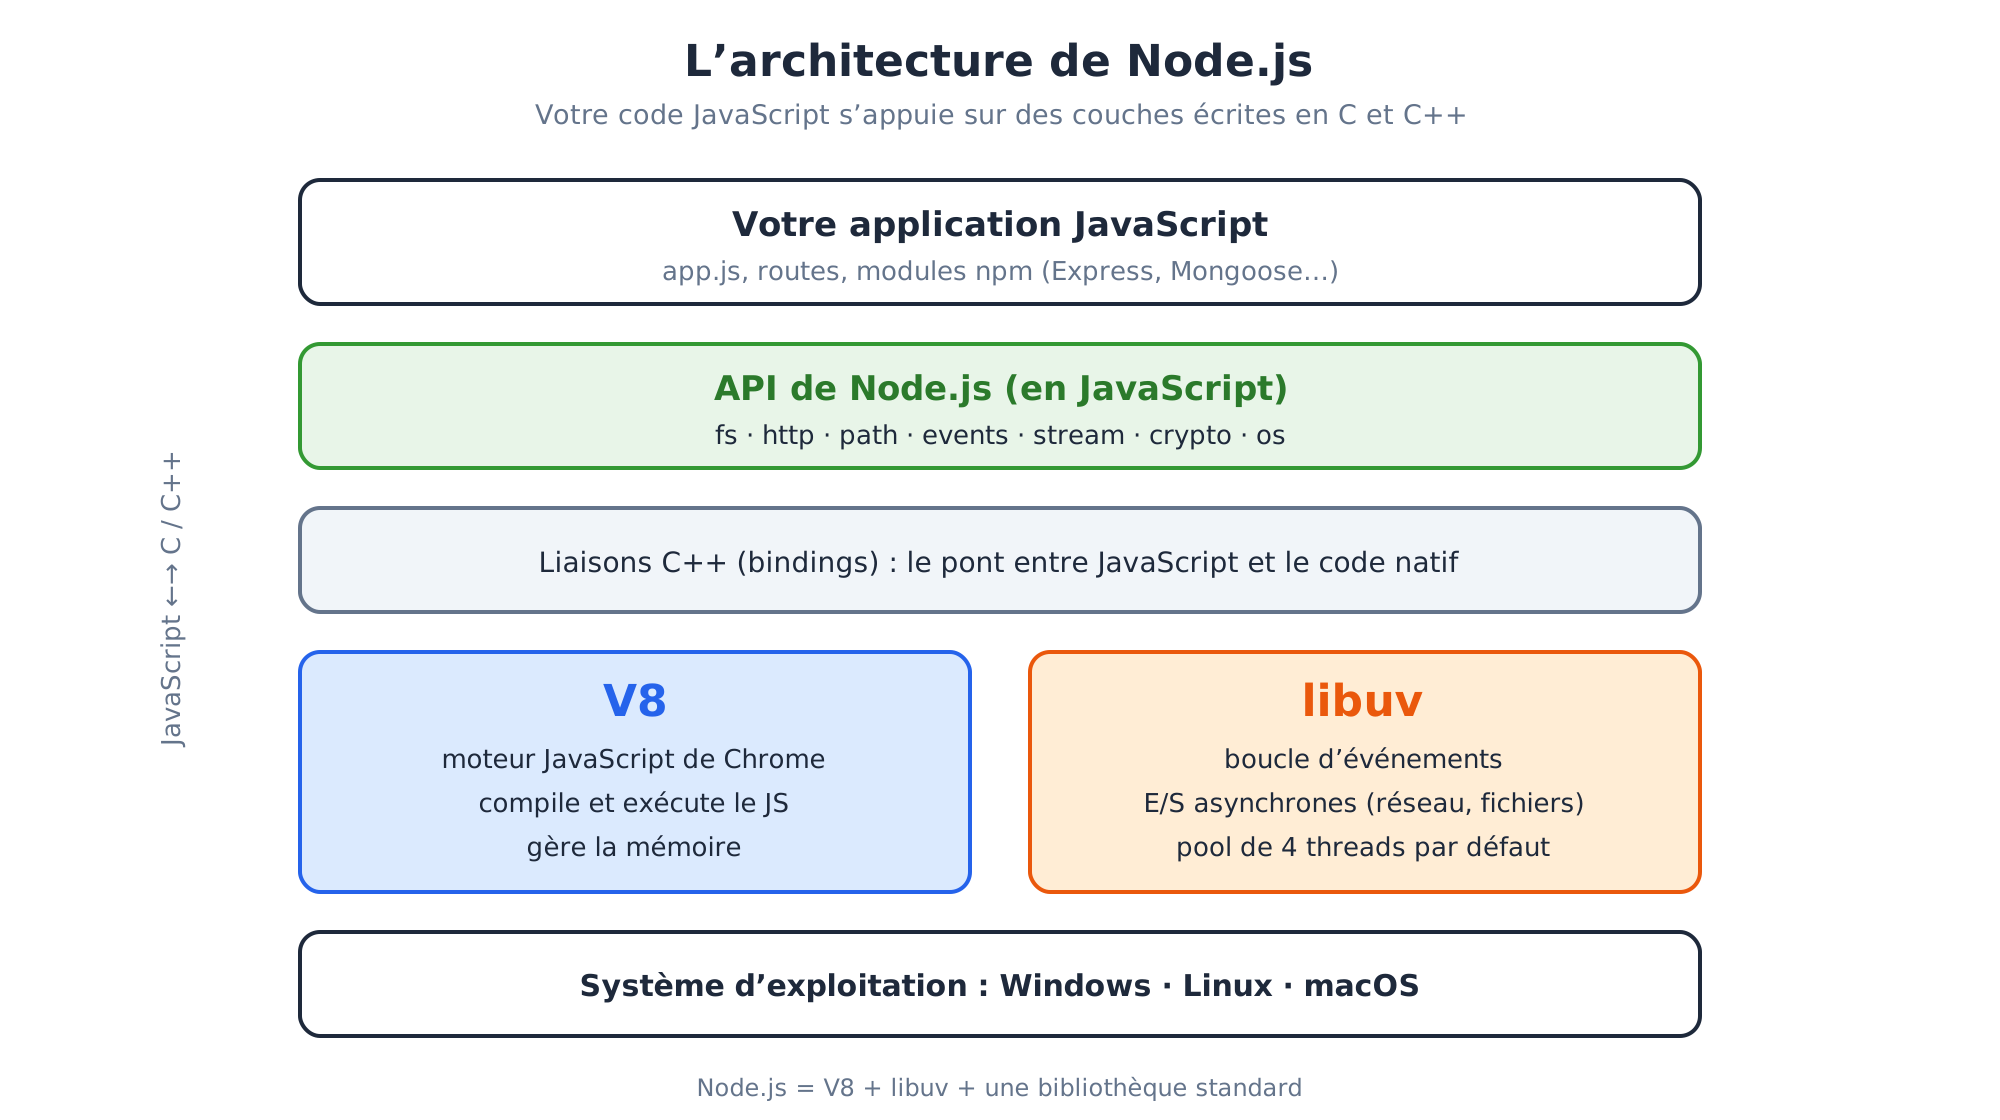 « Node.js n'a qu'un seul thread » : vrai et faux. Votre code JavaScript s'exécute sur un seul fil, c'est vrai. Mais en coulisses, libuv et le système travaillent en parallèle pour lui. Le développeur n'a pas à gérer de threads, ni les problèmes de synchronisation qui vont avec.
Bloquant ou non bloquant ?
- Une opération bloquante (synchrone) arrête le programme jusqu'à ce qu'elle soit terminée. Une opération non bloquante (asynchrone) est lancée, puis le programme continue ; son résultat est traité plus tard, par une fonction de rappel (callback), une promesse ou
await. - Comparez ces deux programmes, qui lisent le même fichier :
// bloquant.js : lecture SYNCHRONE, le programme attend
import { readFileSync } from 'node:fs';

console.log('1. Début');
const contenu = readFileSync(import.meta.filename, 'utf8');
console.log(`2. Fichier lu : ${contenu.length} caractères`);
console.log('3. Fin');
1. Début 2. Fichier lu : 266 caractères 3. Fin// non-bloquant.js : lecture ASYNCHRONE, le programme continue import { readFile } from 'node:fs'; console.log('1. Début'); readFile(import.meta.filename, 'utf8', (erreur, contenu) => { if (erreur) throw erreur; console.log(`3. Fichier lu : ${contenu.length} caractères`); }); console.log('2. Fin du code principal');1. Début 2. Fin du code principal 3. Fichier lu : 323 caractères- Une opération bloquante (synchrone) arrête le programme jusqu'à ce qu'elle soit terminée. Une opération non bloquante (asynchrone) est lancée, puis le programme continue ; son résultat est traité plus tard, par une fonction de rappel (callback), une promesse ou
- Dans la version non bloquante, « Fin du code principal » s'affiche avant le contenu du fichier : Node.js a lancé la lecture, a continué le programme, puis a exécuté la fonction de rappel quand la lecture s'est terminée.
import.meta.filenamedésigne le fichier en cours d'exécution (Node.js 20.11 et plus). Les noms de fonctions suivent une convention simple :readFileSync(avec Sync) est bloquante,readFilene l'est pas.Pourquoi c'est si important pour un serveur
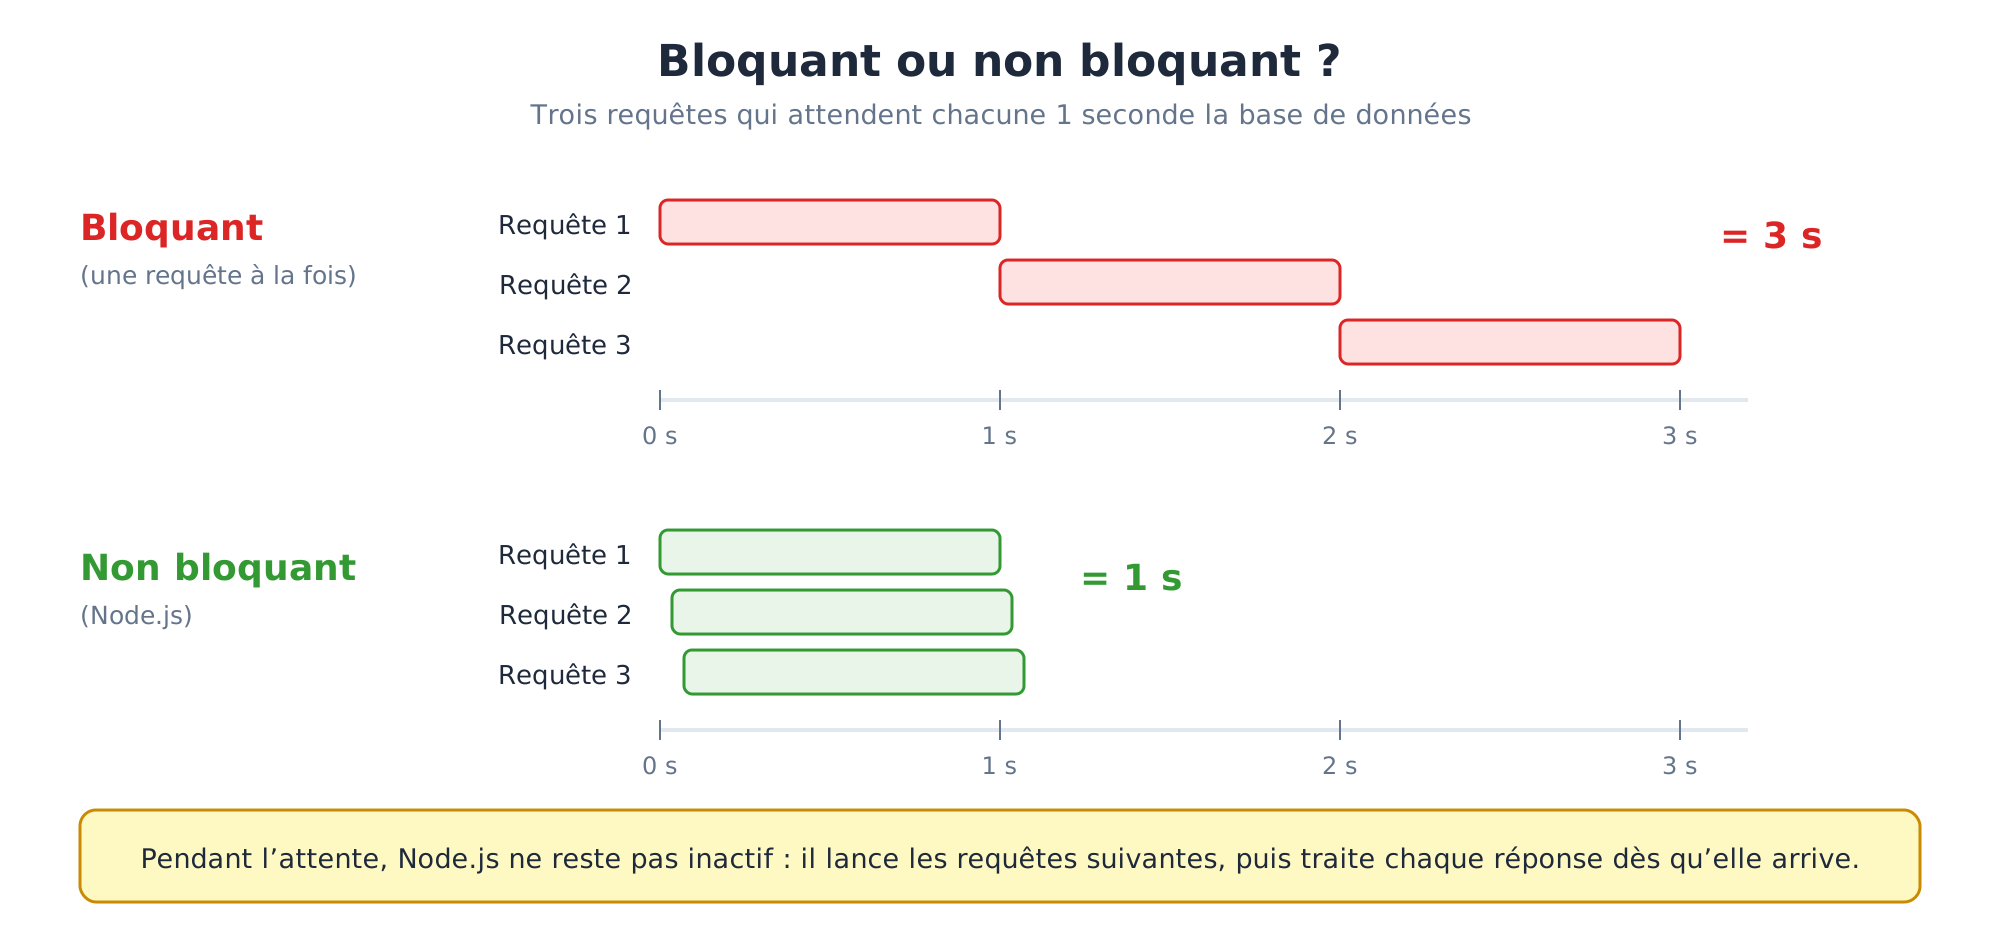
- Un serveur web passe l'essentiel de son temps à attendre: la base de données, un fichier, une API externe. Pendant cette attente, un serveur non bloquant peut traiter d'autres requêtes :
- Ce script simule trois requêtes d'une seconde chacune. On les traite d'abord l'une après l'autre, puis toutes en même temps :
// attente.js : 3 « requêtes » de 1 seconde chacune
const requete = (nom) =>
  new Promise((resolve) => setTimeout(() => resolve(`${nom} terminée`), 1000));

console.time('en série');
await requete('R1'); await requete('R2'); await requete('R3');
console.timeEnd('en série');

console.time('en parallèle');
const resultats = await Promise.all([requete('R1'), requete('R2'), requete('R3')]);
console.timeEnd('en parallèle');
console.log(resultats);
en série: 3.004s en parallèle: 1.002s [ 'R1 terminée', 'R2 terminée', 'R3 terminée' ]- Les trois attentes se chevauchent : le total passe de 3 secondes à 1 seconde, avec un seul fil d'exécution.
La boucle d'événements en bref
- Quand vous lancez
node app.js, Node.js exécute d'abord tout le code du fichier, de haut en bas. Ensuite, tant qu'il reste quelque chose à attendre (un minuteur, un serveur qui écoute, une lecture en cours), la boucle d'événements tourne. À chaque tour, elle :- exécute les minuteurs arrivés à échéance (
setTimeout,setInterval) ; - récupère les entrées / sorties terminées (fichier lu, requête reçue) et exécute leurs fonctions de rappel ;
- exécute les rappels programmés avec
setImmediate; - entre chaque étape, vide la file des promesses résolues (les « microtâches »).
- exécute les minuteurs arrivés à échéance (
- Quand il n'y a plus rien à attendre, le programme s'arrête. C'est pourquoi un script simple se termine tout seul, alors qu'un serveur reste actif : il attend des requêtes.
- Vous étudierez la boucle d'événements en détail au chapitre 5. Pour l'instant, retenez l'ordre : code synchrone d'abord, puis promesses, puis minuteurs et entrées / sorties.
- Quand vous lancez
Ce qui bloque un serveur Node.js
- Le revers du fil unique : si votre code JavaScript fait un long calcul, plus rien d'autre ne s'exécute. Dans ce serveur, l'adresse
/calculfait une boucle de 3 milliards de tours :
// bloque-boucle.js : un calcul long bloque TOUT le serveur import http from 'node:http'; http.createServer((requete, reponse) => { if (requete.url === '/calcul') { let somme = 0; for (let i = 0; i < 3e9; i++) somme += i; // plusieurs secondes de calcul return reponse.end(`Somme : ${somme}\n`); } reponse.end('Réponse immédiate\n'); }).listen(3000, () => console.log('http://localhost:3000'));- Le revers du fil unique : si votre code JavaScript fait un long calcul, plus rien d'autre ne s'exécute. Dans ce serveur, l'adresse
- Ouvrez
http://localhost:3000/calculdans un onglet, puis tout de suitehttp://localhost:3000/dans un autre. La page qui devrait être « immédiate » attend la fin du calcul. Sur notre machine de test, elle a mis plus de 2 secondes à répondre, au lieu de quelques millisecondes. - Les règles d'or qui en découlent :
- dans un serveur, utilisez toujours les versions asynchrones (
readFile,fs/promises) ; les versions…Syncsont réservées aux scripts et au démarrage ; - ne faites jamais de long calcul dans une requête : découpez-le, confiez-le à un
worker_thread, ou à un autre service ; - attention aux boucles sur des tableaux de millions d'éléments et aux expressions régulières mal écrites, qui peuvent bloquer le serveur.
- dans un serveur, utilisez toujours les versions asynchrones (
Activité 1 : prédire l'ordre d'affichage
- Sans l'exécuter, notez dans quel ordre ce programme affiche les lettres. Vérifiez ensuite avec
node ordre.js.
// ordre.js : dans quel ordre ces lignes s'affichent-elles ?
console.log('A');
setTimeout(() => console.log('B'), 0);
Promise.resolve().then(() => console.log('C'));
console.log('E');
Voir le corrigé
A
E
C
B
A et E sont du code synchrone : ils s'affichent d'abord, dans l'ordre. Ensuite viennent les promesses (C), puis les minuteurs (B), même avec un délai de 0 ms : un délai de 0 signifie « dès que possible, après le code en cours », et non « immédiatement ».
- Sans l'exécuter, notez dans quel ordre ce programme affiche les lettres. Vérifiez ensuite avec
Activité 2 : mesurer le blocage
- Lancez
bloque-boucle.js, puis reproduisez l'expérience à deux onglets décrite plus haut. - Questions :
- Combien de temps la page
/met-elle à s'afficher pendant le calcul ? Et sans calcul en cours ? - Remplacez
3e9par3e7. Que constatez-vous ? - Pourquoi ce problème n'existerait-il pas si
/calculattendait seulement une réponse de la base de données pendant 3 secondes ?
- Combien de temps la page
- Pendant le calcul, la page attend la fin de la boucle (plusieurs secondes selon la machine). Sans calcul, elle s'affiche en quelques millisecondes.
- Le calcul dure environ 100 fois moins longtemps : le blocage devient imperceptible. Ce n'est pas le calcul en lui-même qui pose problème, mais sa durée.
- Attendre la base de données est une entrée / sortie : Node.js la confie au système et reste libre de répondre aux autres requêtes. Une boucle de calcul, elle, occupe le fil JavaScript lui-même.
Voir le corrigé
- Lancez
À retenir
- Node.js = V8 (exécute le JavaScript) + libuv (boucle d'événements et entrées / sorties asynchrones) + une bibliothèque standard (fs, http…).
- Votre code s'exécute sur un seul fil; les attentes sont confiées au système et à libuv.
- Une opération non bloquante est lancée, puis son résultat est traité plus tard par un callback, une promesse ou
await. - Ordre d'exécution : code synchrone, puis promesses, puis minuteurs et entrées / sorties.
- Un long calcul bloque tout le serveur : il faut l'éviter dans une requête.
Testez-vous
- 1. Quel est le rôle de V8 ? Et celui de libuv ?
- 2. Laquelle de ces fonctions est bloquante :
fs.readFileoufs.readFileSync? - 3. Pourquoi un serveur Node.js peut-il gérer des milliers de connexions avec un seul fil d'exécution ?
- 4. Un collègue veut générer des miniatures de 500 photos dans une route Express. Quel risque voyez-vous ?
- V8 compile et exécute le JavaScript, et gère la mémoire. libuv fournit la boucle d'événements et les entrées / sorties asynchrones, sur tous les systèmes.
fs.readFileSync(suffixe Sync).- Parce que les connexions passent l'essentiel de leur temps à attendre ; ces attentes ne bloquent pas le fil, qui traite les événements les uns après les autres dès qu'ils arrivent.
- Le traitement d'images est un calcul lourd : il bloquerait le fil unique et toutes les autres requêtes attendraient. Il faut le confier à un worker ou à une file de tâches.
Voir les réponses